
影片繞客廳一圈,地平線 LoFT 把房間的深淺量了出來

拿手機繞著沙發走一圈,畫面裡有電視櫃、有窗簾,可能還有一隻入鏡的貓。這幾秒鐘對人是再平常不過的掃視,對機器卻是一道綜合題:鏡頭此刻在哪、視角有多寬、畫面裡每樣東西離鏡頭多遠、這個房間究竟是什麼形狀。2026 年 11 月 18 日,地平線機器人實驗室發布原生影片幾何基礎模型 LoFT(Looped Foundation Transformer for Video Geometry),交的正是這份答卷(來源:官方公告,另見 IT 之家公開報導)。
一段彩色影片,要交出四種答案
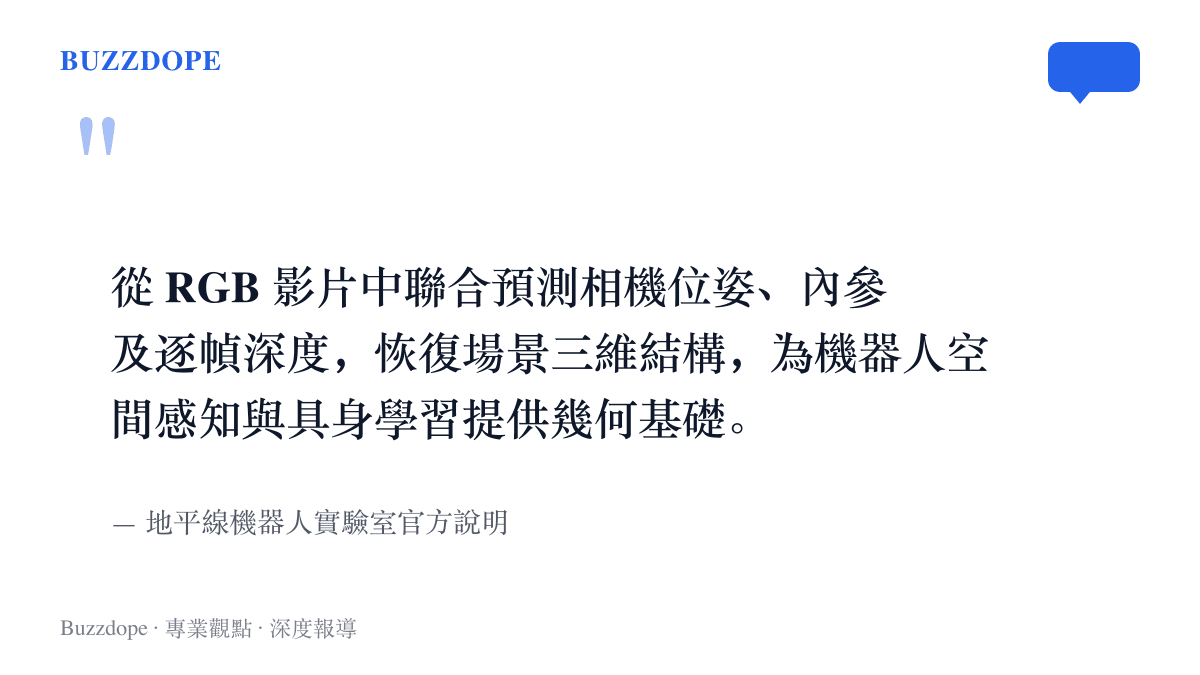
LoFT 的輸入很乾淨:一段普通的 RGB 影片。沒有深度相機,沒有雷射掃描,就是手機能拍到的那種畫面。輸出則被官方拆成四件事:
- 相機位姿:鏡頭在空間裡的位置與朝向,等於替拍攝者畫出行走軌跡。
- 相機內參:焦距、成像中心這類鏡頭參數。手機主鏡頭與超廣角拍同一面牆,變形方式不同,差別就在內參。
- 逐幀深度:每一格畫面裡,每個點離鏡頭多遠。
- 三維結構與置信度:把前面的資訊合起來還原場景形狀,模型同時附上自己對每個判斷的把握程度。
架構上,官方稱之為雙循環 Transformer。第一個循環以局部與全局的時序注意力聚合跨幀資訊,逐步擴大時間上的感受範圍,把相鄰畫面的連續性與跨視角的幾何關聯一起喫進來;第二個循環反覆更新相機位姿與內參,再把更新後的相機狀態回饋到下一輪特徵計算。換個說法,你走進陌生房間先掃一眼,接著邊走邊修正「原來那面牆比想像中遠」的判斷,走回頭路時大腦也在做同樣的事。LoFT 全名拆開是 Looped Foundation Transformer,縮寫恰好是英文的「閣樓」,一個專門堆放形狀與舊物的地方,拿來安置幾何模型不算突兀。
9.62 億幀,等於一年多不關機的畫面
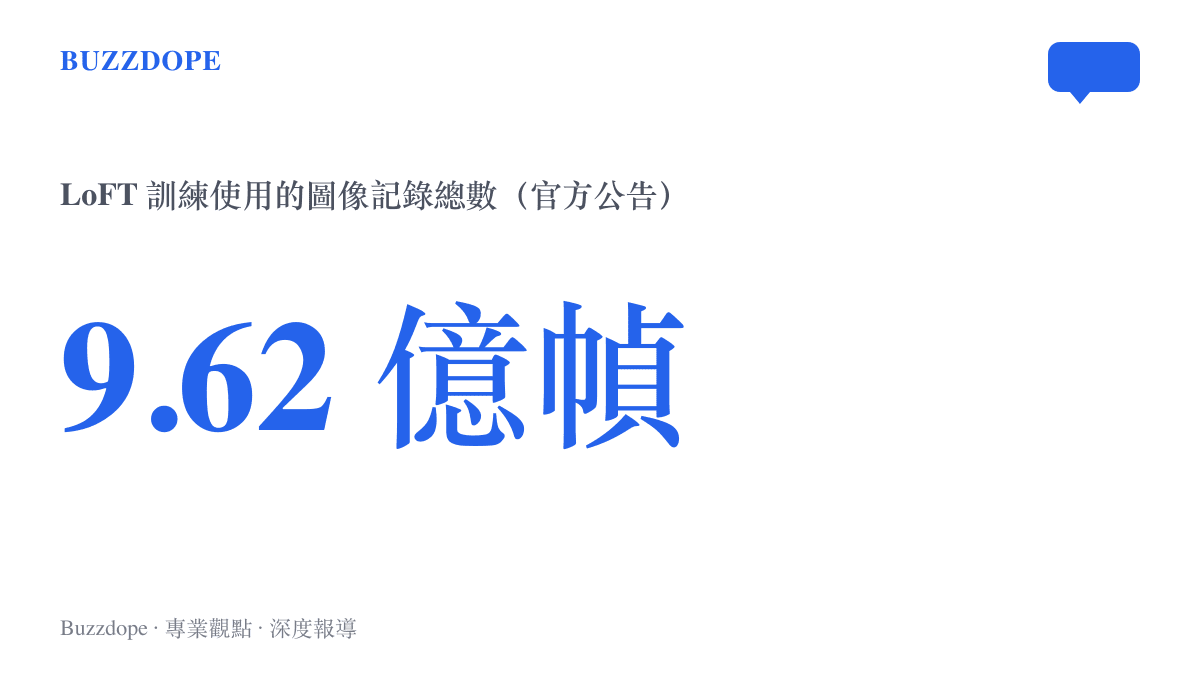
為了餵飽這個模型,團隊搭建了統一的三維重建資料處理與訓練平臺。官方給出的規模是:約 297 萬條有效訓練序列、9.62 億幀圖像記錄,覆蓋模擬與真實、動態與靜態等場景,並經過統一的資料清洗、品質篩選與採樣策略(來源:官方公告)。9.62 億幀換算下來,以電影每秒 24 格計,約當四百六十天連續播放的畫面,一年多不關機。
人類這邊有現成的對照。1960 年,康乃爾大學的吉布森與沃克設計了視覺懸崖實驗:桌面上蓋著透明玻璃,其中半邊看起來懸空,剛學會爬的嬰兒多半爬到邊緣就停住。深度線索一部分與生俱來,更細的判斷要靠爬行與走動的經驗慢慢校準。機器沒有前庭也沒有爬行期,它的移動經驗就是那 297 萬段影片,在模擬街道、動態廚房與靜態房間之間來回累積。
從立體鏡到街景,量深淺這件事走了快兩百年
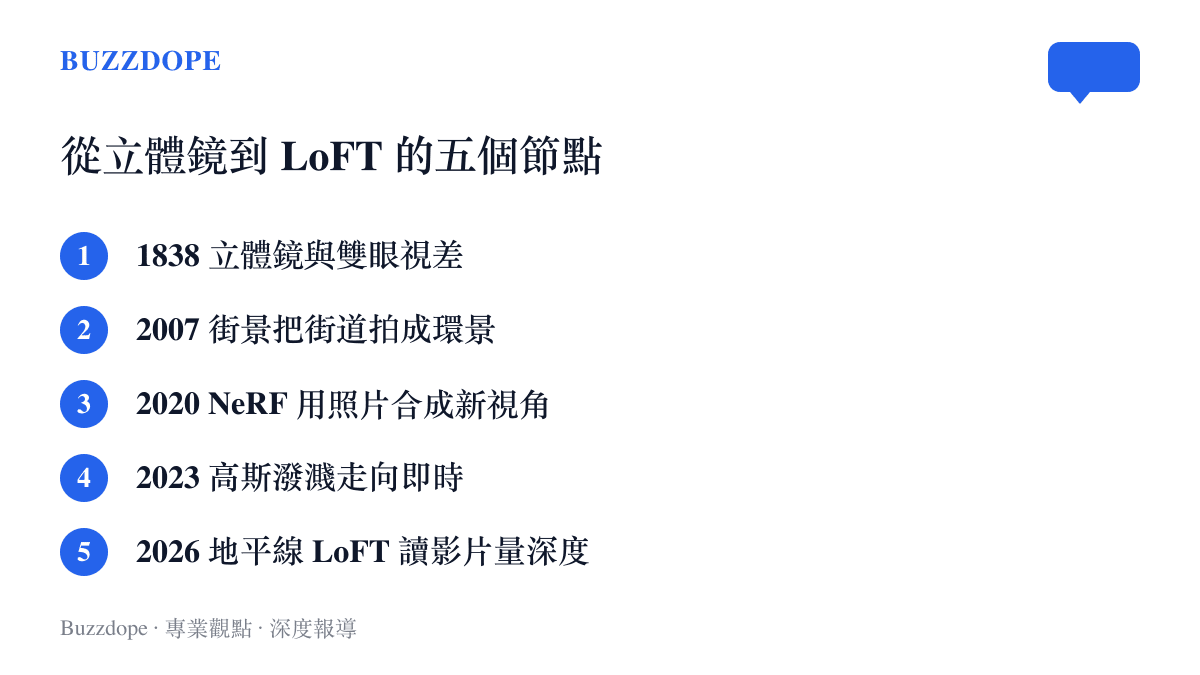
用平面畫面還原立體世界,人類自己先著迷過一輪。1838 年,惠斯通發明立體鏡,靠雙眼視差讓兩張平面圖疊出縱深;二十世紀的攝影測量把航拍照片變成地圖,2007 年上線的街景服務再讓整條街成為可以移動的環景。2020 年的 NeRF 拿下 ECCV 最佳論文獎,用一組照片合成新視角的展示影片在 YouTube 與 Reddit 被反覆轉發;2023 年的高斯潑濺獲 SIGGRAPH 最佳論文,重建快到遊戲與 VR 圈把它接進製作流程;2025 年,VGGT 在 CVPR 獲頒最佳論文獎,開源後沒幾天,社羣就拿它重建自家的客廳與辦公室。LoFT 站在這條線的末端,輸入從一組照片換成連續影片,服務對象也從設計師與開發者,明確指向機器人。
人與機器在這件事上的方向剛好相反。本站先前寫過,有 Mac 用戶把macOS 桌布裡曬了十幾年夕陽的半穹頂排進加州自駕行程,專程去看螢幕風景的本尊;機器做的則是把螢幕裡的影片倒回去,算出風景原本的形狀。一邊從像素走向山谷,一邊從畫面量回空間。
SoTA 從論文表格走進新聞稿
評測部分,研究團隊選了三套基準:SpatialBench 覆蓋 12 個資料集、98 個連續影片場景;ClassicBench 整合 7 個經典影片重建基準;VRBench 涵蓋機器人、自動駕駛與通用影片場景。對比對象包括 VGGT-Ω、DA3-Giant 等代表模型,官方稱 LoFT 在多項深度估計指標上達到 SoTA(來源:官方公布資訊)。名單裡的 DA3-Giant 屬於 Depth Anything 系列,這個系列以單張照片的深度估計聞名,在開源圈使用廣泛,各種背景處理的示範裡常見其身影。
SoTA,State of the Art,論文表格裡的行話,意思是現有方法裡的最好成績。這個詞這幾年從學術會議走進科技公司的新聞稿,看到它時可以記住兩件事:其一,它指特定基準上的特定指標;其二,指標領先與實際好用之間,還隔著同行複現與實機檢驗。地平線此次公布的是官方評測數字,模型之後在論文圈與社羣會被怎麼檢驗,是接下來的看點。
機器人的眼睛,先從看懂廚房開始
應用側,官方列出的場景包括機器人第一人稱影片、動態街道、室內操作與開放環境探索;展示案例裡有高頻動態場景的空間感知,有文字級的精細幾何重建,連招牌上的字都留在幾何細節裡,還有駕駛場景中對移動車輛的穩定重建。這些畫面對人的眼睛是常識,對機器是課表。
地平線在新聞裡的常見身份,是供應車用輔助駕駛晶片的公司,徵程系列裝在多款量產車上,連人民幣 7.98 萬元起的捷達 M6 都用上徵程 6M(來源:IT 之家公開報導)。實驗室的模型研究是另一條線,兩條線指向同一個方向:讓機器在真實空間裡行動。這個方向最近被反覆提起,我們先前寫過雷軍替 AI 算了一筆帳、把機器人排到汽車前頭,他認為具身智慧的想像空間會超過汽車產業。幾何基礎模型做的,正是替這批還在實驗室與展會之間移動的機器,補上「看懂房間」這一課。
下次繞沙發拍片,也許是在替幫手畫地圖
影像辨識花了十幾年,教會機器認出畫面裡的貓與沙發;這一回的功課是分清哪個近、哪個遠、自己走到了哪裡。等這一課普及,你隨手繞客廳拍下的一段影片,也許就是未來某個幫手的第一份地圖。到那時,第一個被機器量清楚深淺的房間,會是廚房、車庫,還是你此刻坐著的這一間?