
洛谷刷出整排 AC,GPT-6-Astra 把競程紀錄推高一格

洛谷的提交列表裡,綠色的 AC 是競程生最熟悉的畫面。Accepted,通過,這題收工,換下一題。近日,這排綠色出現在一批不太一樣的提交紀錄裡:答題的一方是模型 GPT-6-Astra,通過題目的難度一路爬向資訊競賽圈公認的天花板,社羣整理的「AI 爆題總結」跟著翻新了紀錄(來源:洛谷社羣整理)。知乎上很快長出對應的提問,答題區湧進正在備賽的學生、退役選手,和純粹來圍觀的人。
先把兩個詞說清楚。洛谷是大陸規模數一數二的競賽程式練習平臺,題目按難度分級,每道題底下累積著使用者寫的題解;臺灣的資訊奧林匹亞(TOI)選手,同樣常在這類平臺與 Codeforces、AtCoder 上練兵。「爆題」是圈內說法,意思是短時間內大量解題,像推土機碾過題單。所謂「AI 爆題總結」,就是把模型的答題成績整理成發榜式文章的固定文體,這回刷新的紀錄,就收在這類整理與知乎的轉述裡。
一份總結,把題庫變成 AI 的考場
這個文體的流行,本身就是一段故事。每逢強模型發表,總有人第一時間把它抓去題庫考試,統計 AC 率、記下穩定通過的難度等級,再回社羣發榜。一份份成績單逐次疊高,讀起來像 AI 的段位升等史。GPT-6-Astra 這回被整理出來的表現,按洛谷社羣與知乎答題區的轉述,觸及了過往模型容易卡關的難度區間(來源:洛谷社羣整理、知乎討論)。順帶一提,題面說的「複雜度」,取的是圈內口語裡「題目難度」的意思,與演算法分析的時間複雜度是兩回事。
洛谷的題庫按難度分級,大致是這樣一條階梯:
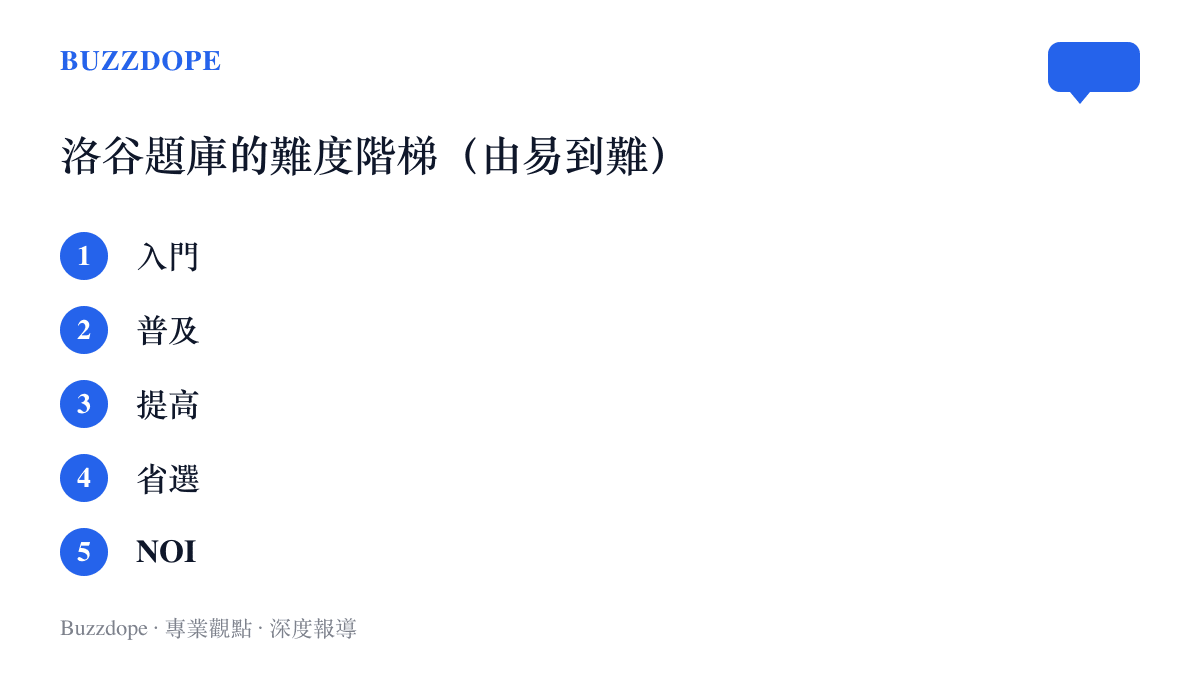
實際的標籤切得更細,中間掛滿正負號與斜線的過渡等級。粗略換算:普及對應入門到國中水準,省選與 NOI 是百裡挑一的競賽頂端,許多選手練滿整個中學階段,仍未必摸得到 NOI 的門檻。難度紀錄每往上推一格,「AI 能做出賽場最難那批題」的日子就近一步。
題解區也被捲進討論。洛谷的題解區由使用者自願撰寫、層層疊起,是這個社羣的心臟;AI 生成的題解該不該發、要不要標註,知乎答題區裡有一派聲音在問。這條線最後怎麼畫,得由平臺定規矩,目前沒有結論。
AI 上考場,走了四年多
把時間軸拉長會發現,AI 考競程題的歷史,比「AI 會寫程式」這個印象老得多。
- 2022 年 2 月:DeepMind 的 AlphaCode 論文登上《科學》(Science),在 Codeforces 十場比賽的題目裡解出約三成四,成績約在參賽者的中位數附近(來源:DeepMind 公開論文)。
- 2023 年:AlphaCode 2 在同場地解出八成七的題目,表現優於八成五的參賽者;同年 Codeforces 明文禁止在計分賽提交 AI 生成的程式碼(來源:DeepMind 官方說明、Codeforces 規則)。
- 2024 年 9 月:OpenAI 發表 o1,官方數據顯示它在 Codeforces 壓過近九成參賽者;同年的 IOI(國際資訊奧林匹亞)實驗中,模型在放寬時間與提交次數的條件下達到金牌水準(來源:OpenAI 官方部落格)。
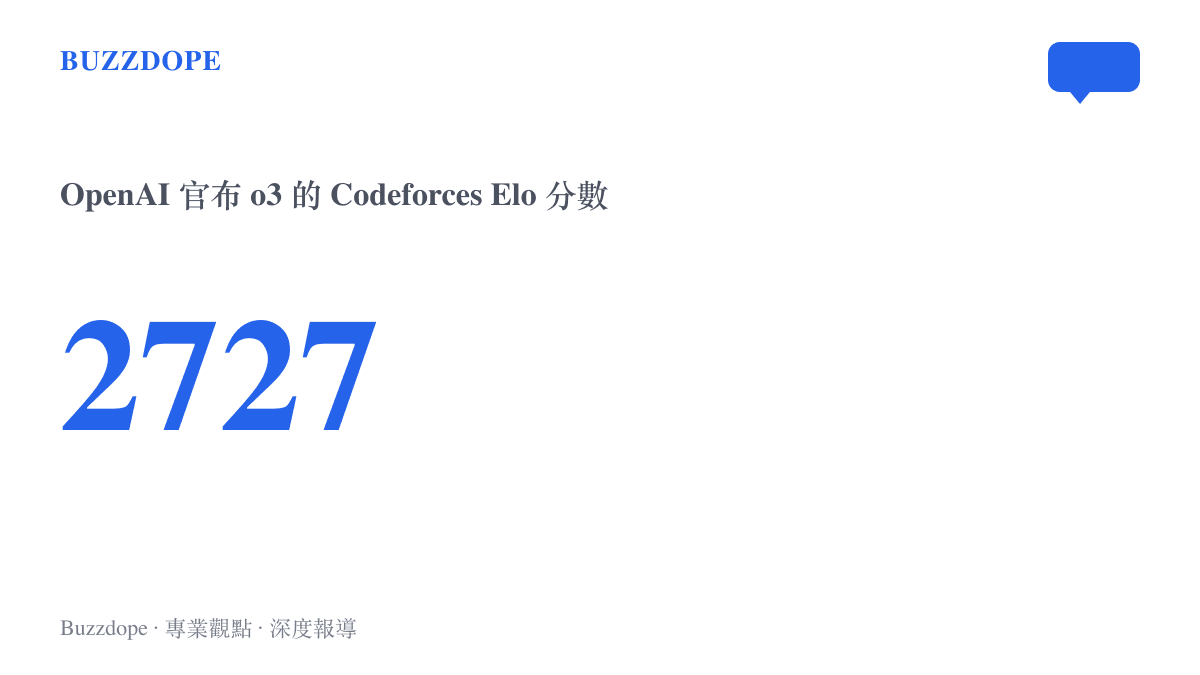
- 2024 年 12 月:o3 發表,官方公布的 Codeforces Elo 分數為 2727,跨過國際特級大師的門檻(來源:OpenAI 官方公告)。
- 2026 年 9 月:GPT-6-Astra 被社羣測出刷新競賽題複雜度紀錄,討論從洛谷延燒到知乎(來源:洛谷社羣整理、知乎討論)。
隔壁的數學賽場走的是同一條路。2024 年,DeepMind 的 AlphaProof 系列在國際數學奧林匹亞(IMO)寫下銀牌水準的成績(來源:DeepMind 官方部落格)。競程與奧數,剛好是升學體系裡最講究硬解題的兩個項目,AI 的成績單先後貼上這兩面牆。
疊代的速度快到什麼程度?快到 Anthropic 執行長 Dario Amodei 回頭寫了那篇 3800 字的減速長文,呼籲同行放慢前沿模型的腳步。對多數人來說,指數曲線是抽象的,洛谷上那排 AC 是具體的。
答題區的兩種語氣
知乎答題區的留言,大致分成兩種語氣。
一種帶著涼意。大陸的 OI 生態與升學綁得深,省選與國賽成績連著保送與升學通道,模型愈強,「賽事含金量會不會縮水」「命題方向會不會被迫改寫」的討論就愈熱。作弊防線也被重新檢查:Codeforces 的禁令、線上賽的行為偵測,能不能擋住把模型帶進賽場的人(來源:知乎答題區討論)。
另一種語氣鬆一些。退役選手寫得直白:題目被 AI 做掉,與他們當年熬夜衝省選的記憶是兩回事;留下來的是拆解問題的習慣、隊友間的默契,還有「這題我調過」的資歷。也有人把話題接到求職,競程訓練的常見終點是演算法面試,而 AI 對這條路的重新定價早已開始。同一年裡,已經有被裁員的工程師回頭讓 AI 幫他重寫履歷,兩邊看的其實是同一件事:純熟的解題技巧,還能兌換多少東西。
圍棋照過來的舊劇本
2016 年,AlphaGo 與李世乭的五番棋把同款震撼演示過一次。當年棋界也被問:人類棋賽還有必要嗎?十年過去,職業圍棋照常開賽,棋手把 AI 收編成最嚴格的教練,開局點三三、各種新定石,都是從 AI 的棋譜裡抄回來的功課。競程圈現在站在同款岔路口:有人想把模型當陪練,有人拿它找命題靈感,也有教練在研究怎麼防它進考場。
差別也很清楚。圍棋的主體是職業棋士,競程的主體是十幾歲的學生,賽事是升學工程的一段。線下的賽場進不去模型,但練習、選拔與訓練體系會怎麼調整,答題區還沒吵出共識。
題庫之外
洛谷的燈還亮著。題庫裡的題目,會一道一道被收進某個模型的 AC 紀錄,難度階梯也會一格一格被爬完。答題區真正還沒解開的,是另一道題:當答案變得便宜,一代學生押在過程上的那些年,該怎麼重新計價。圍棋用十年交出一份答案,競程圈的第一行程式碼,才剛開始寫。